Скоро на канале
Мэтт Каттс: до 30% контента, публикующегося интернете, является дублированным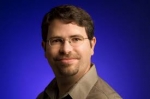
Дата публикации: 18.12.2013
В новом обучающем видеоролике SaveFrom.net для владельцев сайтов, вебмастеров и оптимизаторов глава команды Google по борьбе с веб-спамом Мэтт Катс (Matt Cutts) в очередной раз затронул проблему наличия дублированного контента в глобальной сети.
На этот раз вопрос пользователя из Великобритании звучал так: «Каким образом Google выявляет дублированный контент, и как наличие дубликатов в интернете влияет в целом на ранжирование в выдаче и на будущее всей поисковой оптимизации?» «Прежде всего, важно понимать, что 25-30% всего контента, публикуемого в глобальной сети является дублированным. И это вполне естественно: люди, к примеру, цитируют целые параграфы из блогов, а затем ссылаются на эти блоги – и это в порядке вещей. Таким образом, можно смело утверждать, что наличие такого контента в сети нельзя причислить к категории веб-спама. Мы намеренно сделали такое различие», - начал свой ответ представитель поиска. Тем не менее, в дальнейшей части комментария Мэтт Каттс заявил о том, что на хорошие позиции поисковой выдачи будет попадать только одна страница, содержащая повторяющийся контент, и, в идеале, это должен быть первоисточник. В противном случае, наличие на SERP большого количества страниц с одной и той же информацией приведёт к засорению выдачи. Остальные страницы будут довольствоваться низшими позициями. «Таким образом, Google старается обнаруживать в интернете весь дублированный контент, собирать его воедино и представлять единым блоком. В результате, мы решили показывать на верхних позициях выдачи лучшую из страниц. Остальным же отведено место «в хвосте» выдачи, с тем чтобы обеспечить пользователю максимально исчерпывающий опыт поиска», - продолжил Каттс. Продолжая ответ на вопрос пользователя, он добавил: «В большинстве случаев мы не приравниваем дублированный контент к веб-спаму. Тем не менее, мы все же оставляем за собой право исключать из выдачи сайты, злоупотребляющие дублированием или даже воровством чужого контента, в целях манипулирования поисковой выдачей». «Гораздо больше проблем возникает с теми, кто пытается автоматически генерировать контент на своих ресурсах при помощи RSS-фидов. Как правило, такой контент не имеет добавочной ценности и похож на веб-спам. Однако, если вы создаёте региональные версии сайтов, к примеру, в зонах .com и .co.uk – то вам следует прописать «Условия» для каждого ресурса отдельно. Кроме того, если вы не будете массово копировать контент вашего основного сайта на его региональных версиях – проблемы возникнуть не должно», – добавил Мэтт Каттс. В свою очередь, напомним, что ранее, рассуждая о проблеме о дублированного контента на сайтах интернет-магазинов, представитель поиска заявлял: «В целом, я бы рекомендовал руководствоваться следующим правилом: если один из компонентов страницы содержит ключевой контент, который впоследствии может появляться на других ресурсах – это не критично. Однако если на множестве других ресурсов появляется большая часть контента, содержащегося на вашем сайте, и информация вашего ресурса не имеет никакой добавочной ценности для пользователя – это очень плохой знак для Google». Источник: searchengines Комментарии
Имя:
Комментарий:
Осталось: 250 символов
|

Рекомендуем
Новости блога
Facebook
ВКонтакте
Twitter
Доклады конференций
Новости AdCrunch
Наши проекты |